이진 힙(Binary Heap) 완벽 가이드 1편: 기초부터 시작하기

Dev.Sol
힙(Heap)이란 무엇인가?
**힙(Heap)**은 우선순위 큐를 효율적으로 구현하기 위한 완전 이진 트리(Complete Binary Tree) 기반의 자료구조다.
주의: 이 글에서 다루는 "힙"은 자료구조 Heap이다. 운영체제(OS)의 **힙 메모리(Heap Memory)**와는 전혀 다른 개념이므로 혼동하지 말아야 한다.
자료구조 Heap ≠ OS Heap Memory
힙의 두 가지 종류
힙은 부모-자식 관계에 따라 두 종류로 나뉜다.
1. 최대 힙(Max Heap)
힙 속성: 부모 노드 값이 자식 노드 값보다 크거나 같다.
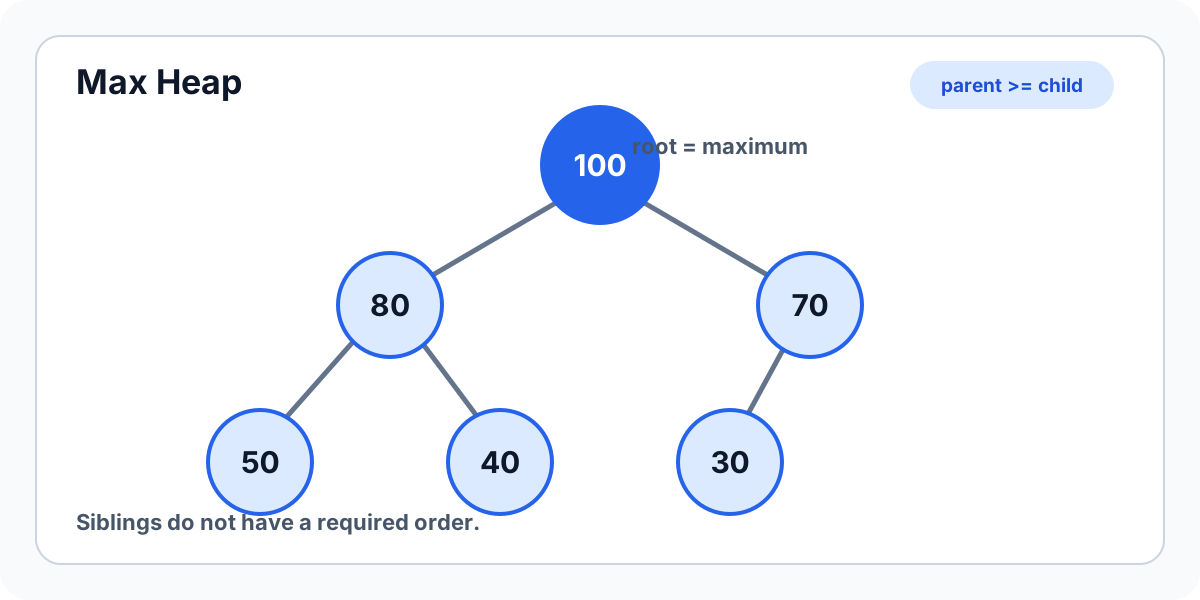
루트에는 최댓값이 오지만, 형제 노드 사이의 순서는 보장되지 않는다.
특징:
- 루트(root) 노드가 최댓값
- 부모 ≥ 자식 (항상 성립)
- 형제(sibling) 간에는 순서 없음 (중요!)
2. 최소 힙(Min Heap)
힙 속성: 부모 노드 값이 자식 노드 값보다 작거나 같다.
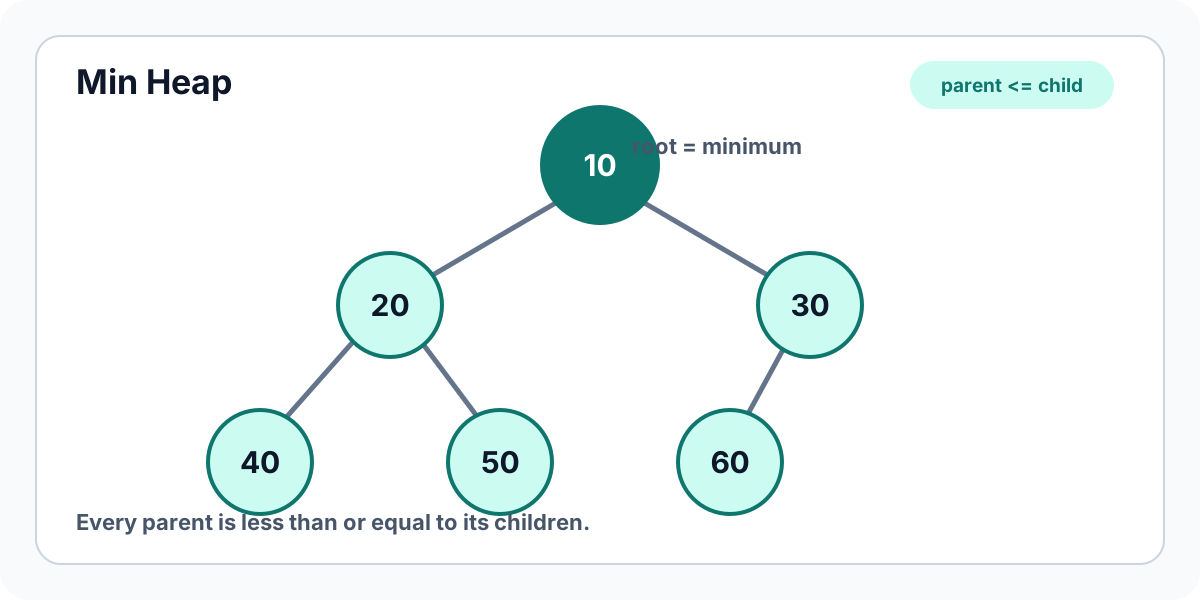
루트에는 최솟값이 오며, 각 부모는 자신의 자식보다 작거나 같다.
특징:
- 루트(root) 노드가 최솟값
- 부모 ≤ 자식 (항상 성립)
- 형제 간 순서 없음
완전 이진 트리(Complete Binary Tree)란?
힙은 반드시 완전 이진 트리 형태를 유지해야 한다.
정의
- 마지막 레벨을 제외한 모든 레벨이 완전히 채워짐
- 마지막 레벨은 왼쪽부터 순서대로 채워짐
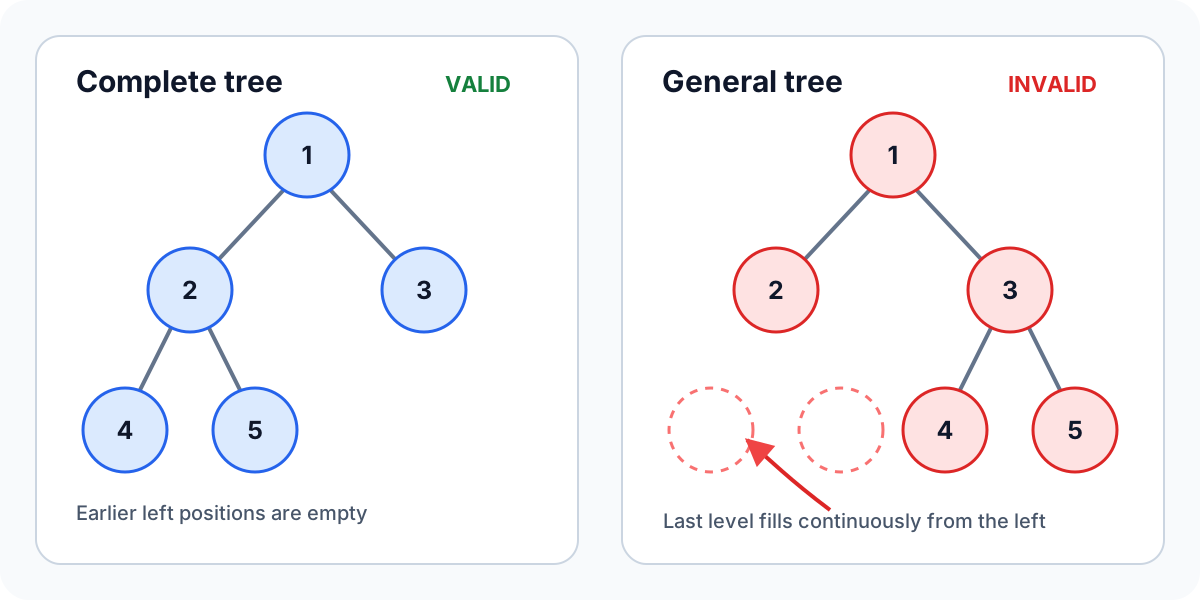
마지막 레벨은 중간을 비우지 않고 왼쪽부터 연속해서 채워야 한다.
오른쪽 트리는 레벨 2에서 왼쪽(2번 노드)이 채워지지 않았으므로 완전 이진 트리가 아니다.
배열로 구현하는 힙
완전 이진 트리의 특성 덕분에 힙은 배열 하나로 효율적으로 표현 가능하다.
배열 인덱스 표현 방식
1-based 인덱스 (루트 = 1)
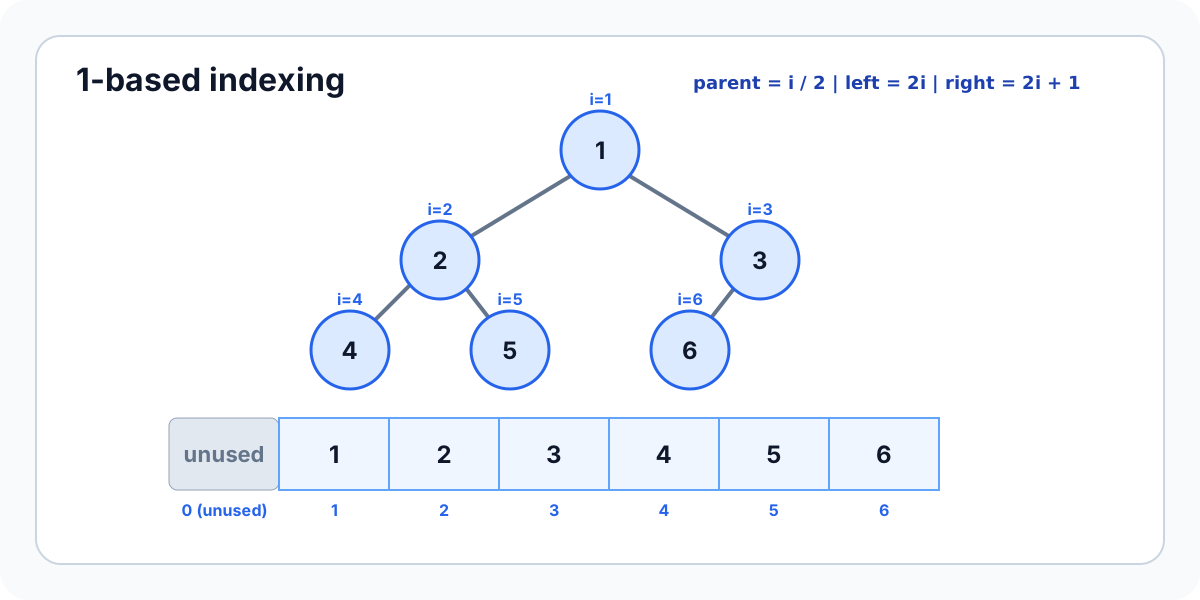
인덱스 0을 비워 두면 부모와 자식 인덱스 공식을 간단하게 표현할 수 있다.
인덱스 공식:
- 부모:
i / 2 - 왼쪽 자식:
2 * i - 오른쪽 자식:
2 * i + 1
0-based 인덱스 (루트 = 0)
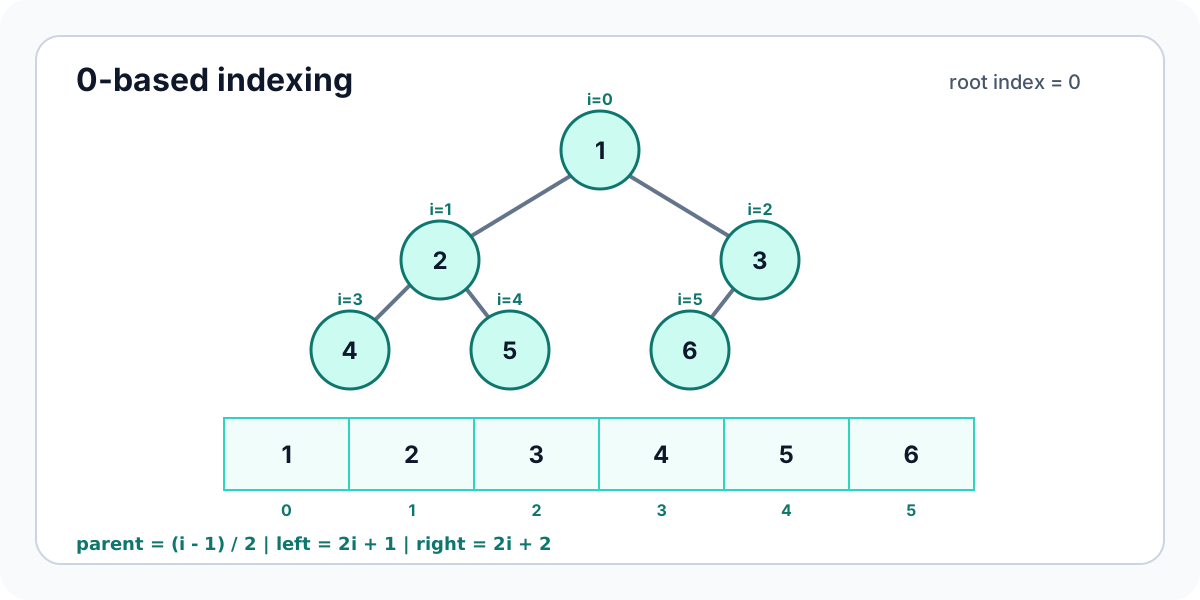
배열의 각 인덱스가 같은 위치의 트리 노드에 바로 대응한다.
인덱스 공식:
- 부모:
(i - 1) / 2 - 왼쪽 자식:
2 * i + 1 - 오른쪽 자식:
2 * i + 2
실무에서는 0-based를 더 많이 사용한다. C++의 std::vector, Java의 ArrayList 등 대부분의 배열 자료구조가 0-based이기 때문이다.
힙의 핵심 연산
1. 삽입(Insert) - O(log n)
절차:
- 배열 맨 끝에 새 원소 추가
- 상향 이동(Sift-Up, Bubble-Up) 수행
상향 이동(Sift-Up): 새 노드를 부모와 비교하며 힙 속성을 만족할 때까지 위로 올린다.
예시: 최대 힙에 90 삽입
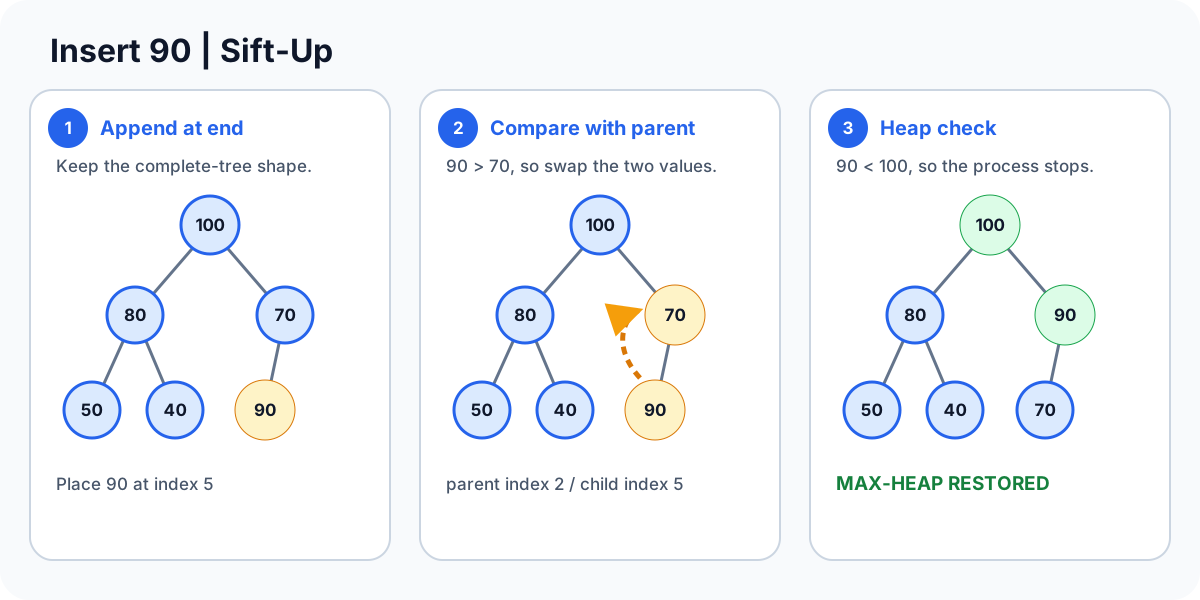
새 원소를 마지막 자리에 추가한 뒤, 부모보다 큰 동안 위로 교환한다.
최악 시간 복잡도: 트리 높이만큼 올라가므로 O(log n)
2. 추출(Extract / Delete-Root) - O(log n)
절차:
- 루트(최댓값 or 최솟값) 반환
- 배열 마지막 원소를 루트로 이동
- 하향 이동(Sift-Down, Heapify-Down) 수행
하향 이동(Sift-Down): 루트를 자식들과 비교하며 힙 속성을 만족할 때까지 아래로 내린다.
예시: 최대 힙에서 루트(100) 추출
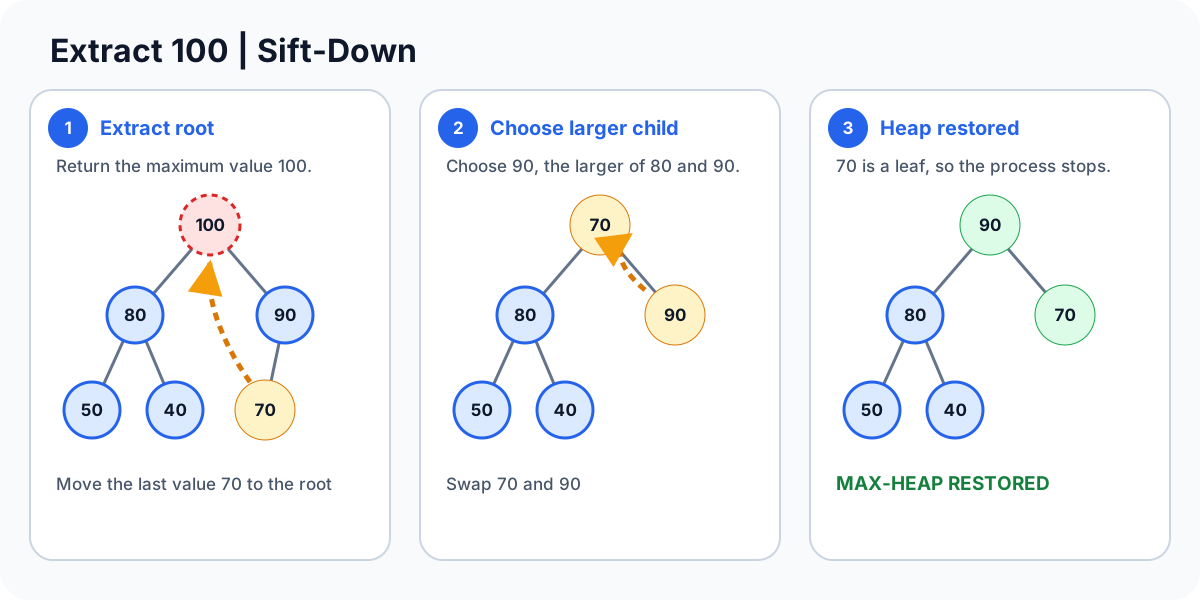
마지막 원소를 루트로 옮긴 뒤, 더 큰 자식과 교환하며 아래로 이동한다.
자식 선택 기준: 최대 힙에서는 더 큰 자식과 swap, 최소 힙에서는 더 작은 자식과 swap
최악 시간 복잡도: 트리 높이만큼 내려가므로 O(log n)
3. 최댓값/최솟값 조회(Peek) - O(1)
int peek() {
    return heap[0];  // 루트가 최댓값(최대 힙) 또는 최솟값(최소 힙)
}
단순히 루트를 반환하므로 **O(1)**이다.
간단한 최대 힙 구현 (C++)
#include <vector>
#include <stdexcept>

class MaxHeap {
private:
    std::vector<int> heap;

    // 부모 인덱스
    int parent(int i) { return (i - 1) / 2; }

    // 왼쪽 자식 인덱스
    int left(int i) { return 2 * i + 1; }

    // 오른쪽 자식 인덱스
    int right(int i) { return 2 * i + 2; }

    // 상향 이동
    void siftUp(int i) {
        while (i > 0 && heap[parent(i)] < heap[i]) {
            std::swap(heap[parent(i)], heap[i]);
            i = parent(i);
        }
    }

    // 하향 이동
    void siftDown(int i) {
        int maxIndex = i;
        int l = left(i);
        int r = right(i);

        // 왼쪽 자식과 비교
        if (l < heap.size() && heap[l] > heap[maxIndex]) {
            maxIndex = l;
        }

        // 오른쪽 자식과 비교
        if (r < heap.size() && heap[r] > heap[maxIndex]) {
            maxIndex = r;
        }

        // 자식이 더 크면 swap 후 재귀
        if (i != maxIndex) {
            std::swap(heap[i], heap[maxIndex]);
            siftDown(maxIndex);
        }
    }

public:
    // 삽입
    void insert(int value) {
        heap.push_back(value);
        siftUp(heap.size() - 1);
    }

    // 추출
    int extractMax() {
        if (heap.empty()) {
            throw std::runtime_error("Heap is empty");
        }

        int maxValue = heap[0];
        heap[0] = heap.back();
        heap.pop_back();

        if (!heap.empty()) {
            siftDown(0);
        }

        return maxValue;
    }

    // 최댓값 조회
    int peek() const {
        if (heap.empty()) {
            throw std::runtime_error("Heap is empty");
        }
        return heap[0];
    }

    // 크기
    size_t size() const {
        return heap.size();
    }

    // 비어있는지 확인
    bool empty() const {
        return heap.empty();
    }
};
시간 복잡도 정리
| 연산 | 시간 복잡도 | 설명 |
|---|---|---|
| 삽입(Insert) | O(log n) | 트리 높이만큼 상향 이동 |
| 추출(Extract) | O(log n) | 트리 높이만큼 하향 이동 |
| 최댓값/최솟값 조회(Peek) | O(1) | 루트 반환 |
| 힙 생성(Build Heap) | O(n) | 배열 전체를 힙으로 변환 (다음 편에서 설명) |
완전 이진 트리의 높이: h = ⌊log₂ n⌋
n개 원소를 가진 힙의 높이는 약 log₂ n이므로, 삽입/삭제가 매우 효율적이다.
힙은 언제 사용하는가?
1. 우선순위 큐(Priority Queue)
가장 큰(또는 작은) 원소를 빠르게 찾아야 할 때:
- 운영체제 스케줄러 (CPU 작업 우선순위)
- 이벤트 기반 시뮬레이션 (가장 빠른 이벤트 처리)
- Dijkstra 최단 경로 알고리즘
2. 힙 정렬(Heap Sort)
O(n log n) 정렬 알고리즘. 추가 메모리 불필요(in-place).
3. Top-K 문제
"가장 큰 K개 원소 찾기" → 크기 K인 최소 힙 사용
다음 화에서 다룰 내용
이제 힙의 기본 개념과 핵심 연산을 이해했다. 하지만 실무에서 힙을 정확하게 다루려면 더 깊이 알아야 할 것들이 많다.
2편 - 배열 인덱싱 심화: 0-based vs 1-based 인덱스, 어떤 상황에서 어느 쪽이 유리한가? 비트 연산으로 인덱스 계산을 최적화하는 방법은?
3편 - Sift 연산의 불변성(Invariant): 상향/하향 이동이 항상 올바른 힙을 만드는 이유는 무엇인가? 수학적 증명과 실전 디버깅 팁.
4편 - Build Heap의 O(n) 마법: 배열을 힙으로 만들 때 왜 O(n log n)이 아니라 O(n)이 가능한가? 놀라운 수학적 직관.
5편 - C++ std::priority_queue 완전 정복 & 함정: make_heap, push_heap, pop_heap의 올바른 사용법. 흔한 실수 사례와 회피 방법.
정리
- 힙 = 완전 이진 트리 + 힙 속성
- 최대 힙: 부모 ≥ 자식
- 최소 힙: 부모 ≤ 자식
- 형제 간 순서 없음 (중요)
- 배열로 효율적 구현 가능
- 0-based: 부모
(i-1)/2, 자식2i+1,2i+2 - 1-based: 부모
i/2, 자식2i,2i+1
- 핵심 연산
- 삽입: 맨 끝 추가 + Sift-Up → O(log n)
- 추출: 루트 제거 + 마지막 원소를 루트로 + Sift-Down → O(log n)
- 조회: 루트 반환 → O(1)
- Build Heap은 O(n) (다음 편 예고)
다음 편에서는 배열 인덱싱을 더 깊이 파고들며, 실무에서 마주치는 미묘한 차이들을 다룬다.